实验 08:哈希映射
常见问题
本实验的常见问题可以在 这里 找到。
简介
在本实验中,你将研究
MyHashMap
,这是
Map61B
接口的基于哈希表的实现。这将与实验 06 非常相似,只是这次我们构建的是
HashMap
而不是
TreeMap
。
完成实现后,你将把你的实现与基于列表的 Map 实现
ULLMap
以及 Java 内置的
HashMap
类(它也使用哈希表)进行性能比较。我们还将比较
MyHashMap
在使用不同数据结构作为桶时的性能。
MyHashMap
概述
我们在
MyHashMap.java
中创建了一个类
MyHashMap
,只有非常少的入门代码。你的目标是实现
MyHashMap
继承的
Map61B
接口中的所有方法,
除了
remove
、
keySet
和
iterator
(实验 08 的可选部分)。对于这些,可以随意抛出一个
UnsupportedOperationException
。
请注意,在实现
Map61B
的所有方法之前,你的代码不会编译。你可以通过编写所有必需方法的方法签名来一次实现一个方法,但对于实现抛出
UnsupportedOperationException
,直到你真正开始编写它们。
复习动画
以下是哈希表工作原理的快速动画。
N
指的是哈希表中的项目数量,
M
指的是桶的数量。
我们使用对象的
hashCode
对桶的数量取模(%)来确定对象(由形状表示)落入哪个桶。当达到负载因子时,我们将桶的数量乘以调整大小因子,并重新哈希所有项目,用新的桶数量对它们取模。
对于下面的视频动画,哈希函数是任意的,为输入的每个形状(对象)输出一个随机整数。
感谢 Meshan Khosla 提供这个动画!
框架代码
你可能从课堂上记得,当我们构建哈希表时,我们可以选择许多不同的数据结构作为桶。经典方法是选择
LinkedList
。但我们也可以选择
ArrayList
、
TreeSet
,甚至其他更疯狂的数据结构,比如
PriorityQueue
甚至其他
HashSet
!
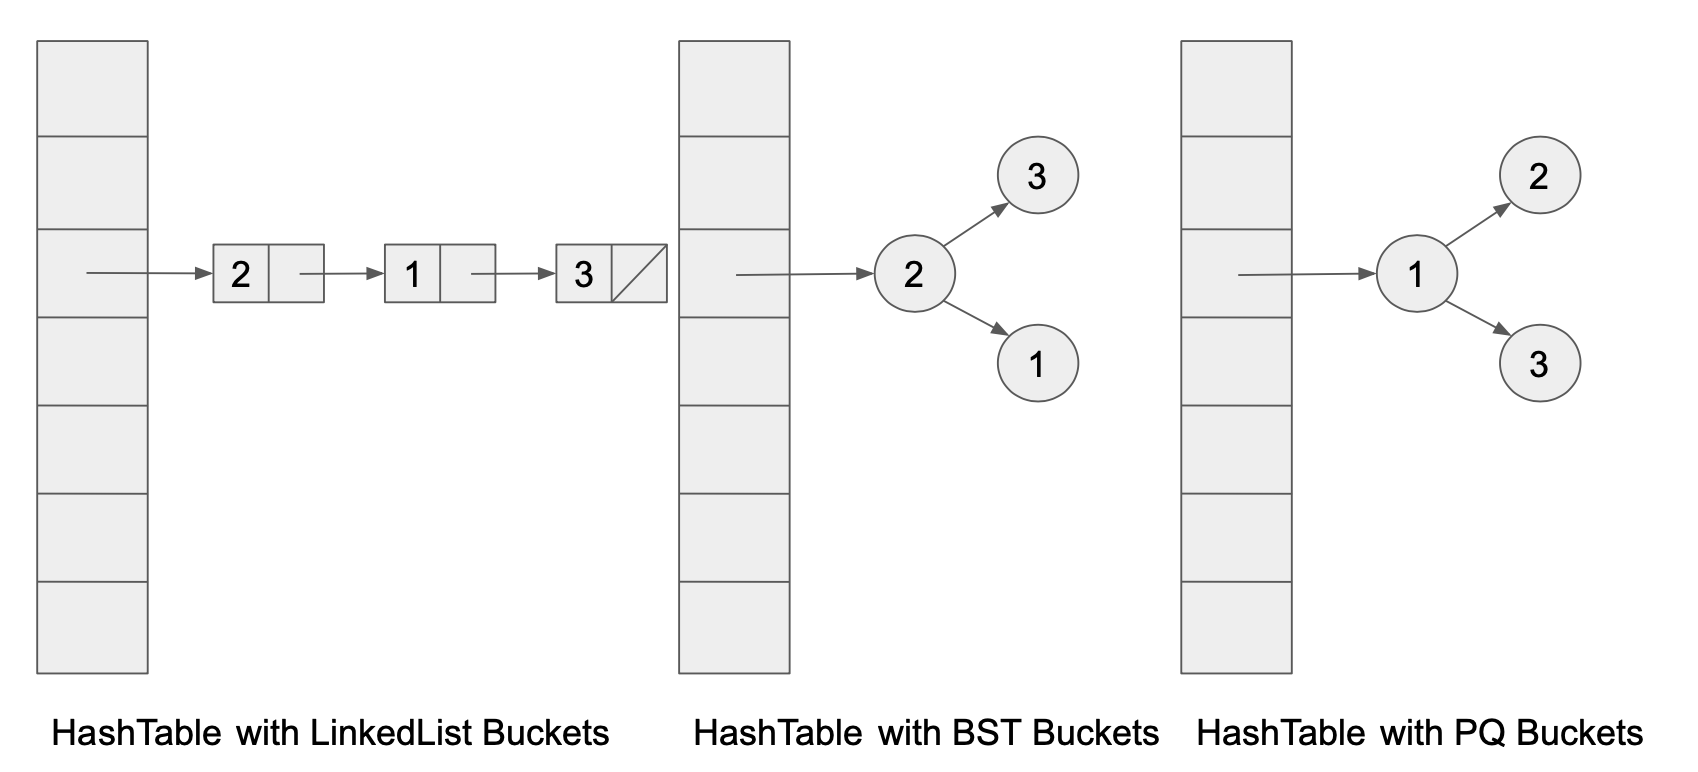
在本实验中,我们将尝试为每个桶使用不同数据结构的哈希表,并根据经验观察使用不同数据结构作为哈希表桶之间是否存在渐近差异。
在本实验中,我们将尝试
LinkedList
、
ArrayList
、
HashSet
、
Stack
和
ArrayDeque
(不幸的是,由于过多的样板代码,没有如上图所示的
TreeSet
或
PriorityQueue
,不过如果你愿意,欢迎尝试)。这是很多类!
你可以想象,如果我们不太在意地实现了
MyHashMap
,那么要用不同的桶类型更换桶类型需要花费大量精力进行查找+替换。例如,如果我们想将所有
ArrayList
桶更改为
LinkedList
桶,我们将不得不查找+替换所有出现的
ArrayList
并将其替换为
LinkedList
。这不理想——例如,我们可能有一个非桶组件依赖于某些
ArrayList
方法。我们不想通过将其更改为
LinkedList
来破坏我们的代码!
入门代码的目的是提供一种更简单的方法来用
MyHashMap
尝试不同的桶类型。它通过多态和继承来实现这一点,我们在本学期早些时候学过这些。它还利用了
工厂方法和类
,它们是用于创建对象的实用代码。这是处理更高级代码时的常见模式,不过细节超出了 61B 的范围。
MyHashMap
通过使用哈希表实现
Map61B
接口。在入门代码中,我们提供了实例变量
private Collection<Node>[] buckets
,这是哈希表的底层数据结构。让我们来分析一下这段代码的含义:
-
buckets是MyHashMap类中的一个private变量。private Collection<节点>[] buckets; -
它是一个
Collection<Node>对象的数组(或表),其中每个Node的Collection代表哈希表中的一个桶 -
Node是我们提供的一个私有(嵌套)辅助类,用于存储单个键值映射。这个类的入门代码应该很容易理解,并且不需要任何修改。protected class 节点 { K key; V value; 节点(K k, V v) { key = k; value = v; } } -
java.util.Collection是大多数数据结构都继承自的接口,它代表一组对象。Collection接口支持add、remove和iterator等方法。java.util中的许多数据结构都实现了Collection,包括ArrayList、LinkedList、TreeSet、HashSet、PriorityQueue等等。请注意,因为这些数据结构实现了Collection,我们可以通过多态将它们赋值给静态类型为Collection的变量。 -
因此,我们的
Collection<Node>对象数组可以由许多不同类型的数据结构实例化,例如LinkedList<Node>或ArrayList<Node>。 确保你的桶可以泛化到任何 Collection! 请参阅下面的警告了解如何做到这一点。 -
在创建新的
Collection<Node>[]以存储在我们的buckets变量中时,请注意在 Java 中,你 不能创建参数化类型的数组 。Collection<Node>是参数化类型,因为我们用Node类参数化了Collection类。因此,Java 不允许new Collection<Node>[size],对于任何给定的size。如果你尝试这样做,你会得到一个"泛型数组创建"错误。
要解决这个问题,你应该改为创建一个
new Collection[size]
,其中
size
是所需的大小。
-
Collection[]的元素可以是任何类型的集合,比如Collection<Integer>或Collection<Node>。 就我们的目的而言,我们只会将Collection<Node>类型的元素添加到我们的Collection[]中。
哈希表的不同实现实现不同桶的机制是通过工厂方法
protected Collection<Node> createBucket()
,它只是返回一个
Collection
。对于
MyHashMap.java
,你可以选择任何你喜欢的数据结构。例如,如果你选择
LinkedList
,
createBucket
的主体将简单地是:
protected Collection<节点> createBucket() {
	return new LinkedList<>();
}
不要使用
new
运算符创建新的桶数据结构,而必须使用
createBucket
方法
。这乍一看可能没用,但它允许我们的工厂类重写
createBucket
方法,以便提供不同的数据结构作为每个桶。
在
MyHashMap
中,你可以让这个方法返回一个新的
LinkedList
或
ArrayList
。
实现要求
你应该实现以下构造函数:
public MyHashMap();
public MyHashMap(int initialCapacity);
public MyHashMap(int initialCapacity, double loadFactor);
MyHashMap
的一些额外要求如下:
-
你的哈希表最初应该有等于
initialCapacity的桶数量。当负载因子超过最大loadFactor阈值时,你应该增加MyHashMap的大小。回想一下,当前的 负载因子 可以计算为loadFactor = N/M,其中N是映射中的元素数量,M是桶的数量。负载因子表示每个桶平均的元素数量。如果没有给出initialCapacity和loadFactor,你应该设置默认值initialCapacity = 16和loadFactor = 0.75(就像 Java 的 内置 HashMap 一样)。 -
你应该使用分离链接来处理冲突。除了桶类、
Collection、Iterator、Set和HashSet之外,你不应该使用任何库。有关如何实现分离链接的更多详细信息,请参阅上面的 框架代码 部分。 -
因为我们对
buckets使用Collection<Node>[],所以在实现MyHashMap时,你只能使用Collection接口指定的方法。 当你在Collection中搜索Node时,遍历Collection,找到其key与所需键.equals()的Node。 -
如果同一个键被插入多次,每次都应该更新值(即,不应该添加
Node)。你可以假设永远不会插入null键。 - 调整大小时,确保以乘法(几何)方式调整大小,而不是以加法(算术)方式调整大小。你 不需要 缩小大小。
-
MyHashMap操作都应该是常数摊销时间,假设任何插入对象的hashCode都能很好地分散事物( 回想一下:Java 中的每个Object都有自己的hashCode()方法 )。
hashCode()
可以返回
负值
!Java 的模运算符
%
对于负输入会返回负值,但我们需要将项目发送到范围 $[0, M)$ 内的桶。有无数种方法可以处理这个问题:
-
(推荐)你可以使用
Math.floorMod()代替%进行模运算。这具有非负值范围,类似于 Python 的模运算。 -
如果
%操作后的结果值为负,你可以将数组的大小加到它上面。 -
你可以使用
Math.abs()函数将负值转换为正值。请注意,$|x| \, \mathrm{mod} \, m$、$|x \, \mathrm{mod} \, m|$ 和 $x \, \mathrm{mod} \, m$ 通常不等价 !我们在这里只是使用模运算来确保我们有一个有效的索引。我们不一定太关心项目进入的确切桶,因为好的哈希函数应该能在正数和负数之间很好地分散事物。 - 选项(3)但使用位掩码(如果你不知道这是什么意思也不用担心)。这超出了 61B 的范围,但一些资源是这样做的,这就是我们把它放在这里的原因。
根据
Map61B
中的规范和上述指南完成
MyHashMap
类。
资源
你可能会发现以下资源很有用
以下内容可能包含过时的代码或使用不熟悉的技术,但应该仍然有用:
-
ULLMap.java(已提供),一个可工作的基于无序链表的Map61B实现
测试
你可以使用
TestMyHashMap.java
测试你的实现。有些测试相当棘手,会做一些我们在 61B 中没学过的奇怪事情。注释将有助于了解测试实际上在做什么。
如果你正确实现了通用
Collection
桶,你也应该通过
TestMyHashMapBuckets.java
中的测试。
TestMyHashMapBuckets.java
文件只是为实现不同桶数据结构的每个不同映射子类调用
TestMyHashMap.java
中的方法。确保你使用提供的工厂方法(即
createBucket
)正确实现了
MyHashMap
,以便
TestHashMapBuckets.java
通过。
如果你选择实现额外的
remove
、
keySet
和
iterator
方法,我们在
TestHashMapExtra.java
中提供了一些测试。
速度测试
InsertRandomSpeedTest.java
和
InsertInOrderSpeedTest.java
中提供了两个交互式速度测试。在完成
MyHashMap
之前,不要尝试运行这些测试。准备就绪后,你可以在 IntelliJ 中运行测试。
InsertRandomSpeedTest
类对你的
MyHashMap
、
ULLMap
(提供)和 Java 内置的
HashMap
进行元素插入速度测试。它通过询问用户输入大小
N
来工作,然后生成长度为
10
的
N
个 String,并将它们作为
<String, Integer>
对插入到映射中。
试试看,看看你的数据结构与简单实现和工业级实现相比,如何随着
N
扩展。在提供的名为
src/results.txt
的文件中记录你的结果。你的结果不需要标准格式,也不需要固定数量的数据点。不过,我们希望你至少写一两句话说明你的观察结果。
现在尝试运行
InsertInOrderSpeedTest
,它的行为与
InsertRandomSpeedTest
类似,只是这次
<String, Integer>
键值对中的
String
按
字典递增顺序
插入。你的代码应该与 Java 的内置解决方案大致相当——比如说,在 10 倍左右的范围内。这告诉我们的是,与最先进的
TreeMaps
相比,最先进的
HashMaps
相对容易实现。考虑一下与
BSTMap
/
TreeMap
和其他数据结构的这种关系——是否存在某些情况
Hashmap
可能更好?与你的同伴讨论这个问题,并将你的答案添加到
results.txt
中。
不同的桶类型
如果你正确实现了通用
Collection
桶,大部分工作就完成了!我们可以直接比较用于实现桶的不同数据结构。我们提供了
speed/BucketsSpeedTest.java
,这是一个交互式测试,它向用户询问一个整数
L
,表示后续操作中使用的字符串长度。然后,在循环中,它向用户询问一个整数
N
,并使用不同类型的桶在你的
MyHashMap
上运行速度测试。
试试看,比较不同实现如何随着
N
扩展。与你的同伴讨论你的结果,并将你的回答记录在
results.txt
中。
你可能会注意到,我们使用
HashSet
作为桶的实现通过遍历整个数据结构来搜索
Node
。但我们知道哈希表支持比这更高效的查找。如果我们能够对
HashSet
使用常数时间搜索,我们的哈希表会渐近地加速吗?你不需要在这里实现任何新东西,只需与你的同伴讨论,并将你的想法记录在
results.txt
中。
在
speed
目录中运行上述速度测试,并在
results.txt
中记录你的结果。
交付成果和评分
本实验满分 5 分。Gradescope 上有一个隐藏测试(检查你的
results.txt
)。其余测试都是本地的。如果你通过了所有本地测试并充分填写了
results.txt
文件,你将在 Gradescope 上获得满分。
以下每项价值 $\frac{5}{11}$ 分,对应一个单元测试:
- 泛型
-
clear -
containsKey -
get -
size -
put - 功能
- 调整大小
- 边界情况
-
桶(所有
TestMyHashMapBuckets) -
results.txt(不在本地测试,但在 Gradescope 自动评分器上测试)
如前所述,如果你不实现
可选练习
,则抛出一个
UnsupportedOperationException
,如下所示:
throw new UnsupportedOperationException();
提交
就像你之前的作业一样,添加、提交,然后将你的实验08代码推送到 GitHub。然后,提交到 Gradescope 来测试你的代码。
可选练习
这些不会被评分,但你仍然可以通过给定的测试获得反馈。
在你的
MyHashMap
类中实现方法
remove(K key)
和
remove(K key, V value)
。作为额外挑战,实现
keySet()
和
iterator()
,不使用第二个实例变量来存储键集。
对于
remove
,如果参数键在
MyHashMap
中不存在,你应该返回
null
。否则,删除键值对(key, value)并返回关联的值。